Java 后端写了多年,业务系统做了不少,这两年 AI 工具也天天在用,但一直停留在「会调 API」的水平:拿个 SDK,拼个 prompt,拿回一段文本。至于一个能自己跑任务、调工具、多轮循环的 Agent 在工程上是怎么搭起来的,我说不清楚。十月底开始,我给自己排了一条学习路线,决定从最底层啃起:不碰现成框架,先把「模型调用」这件事当成一个工程问题解决掉。这篇文章是第一阶段的总结。
第一阶段学了什么
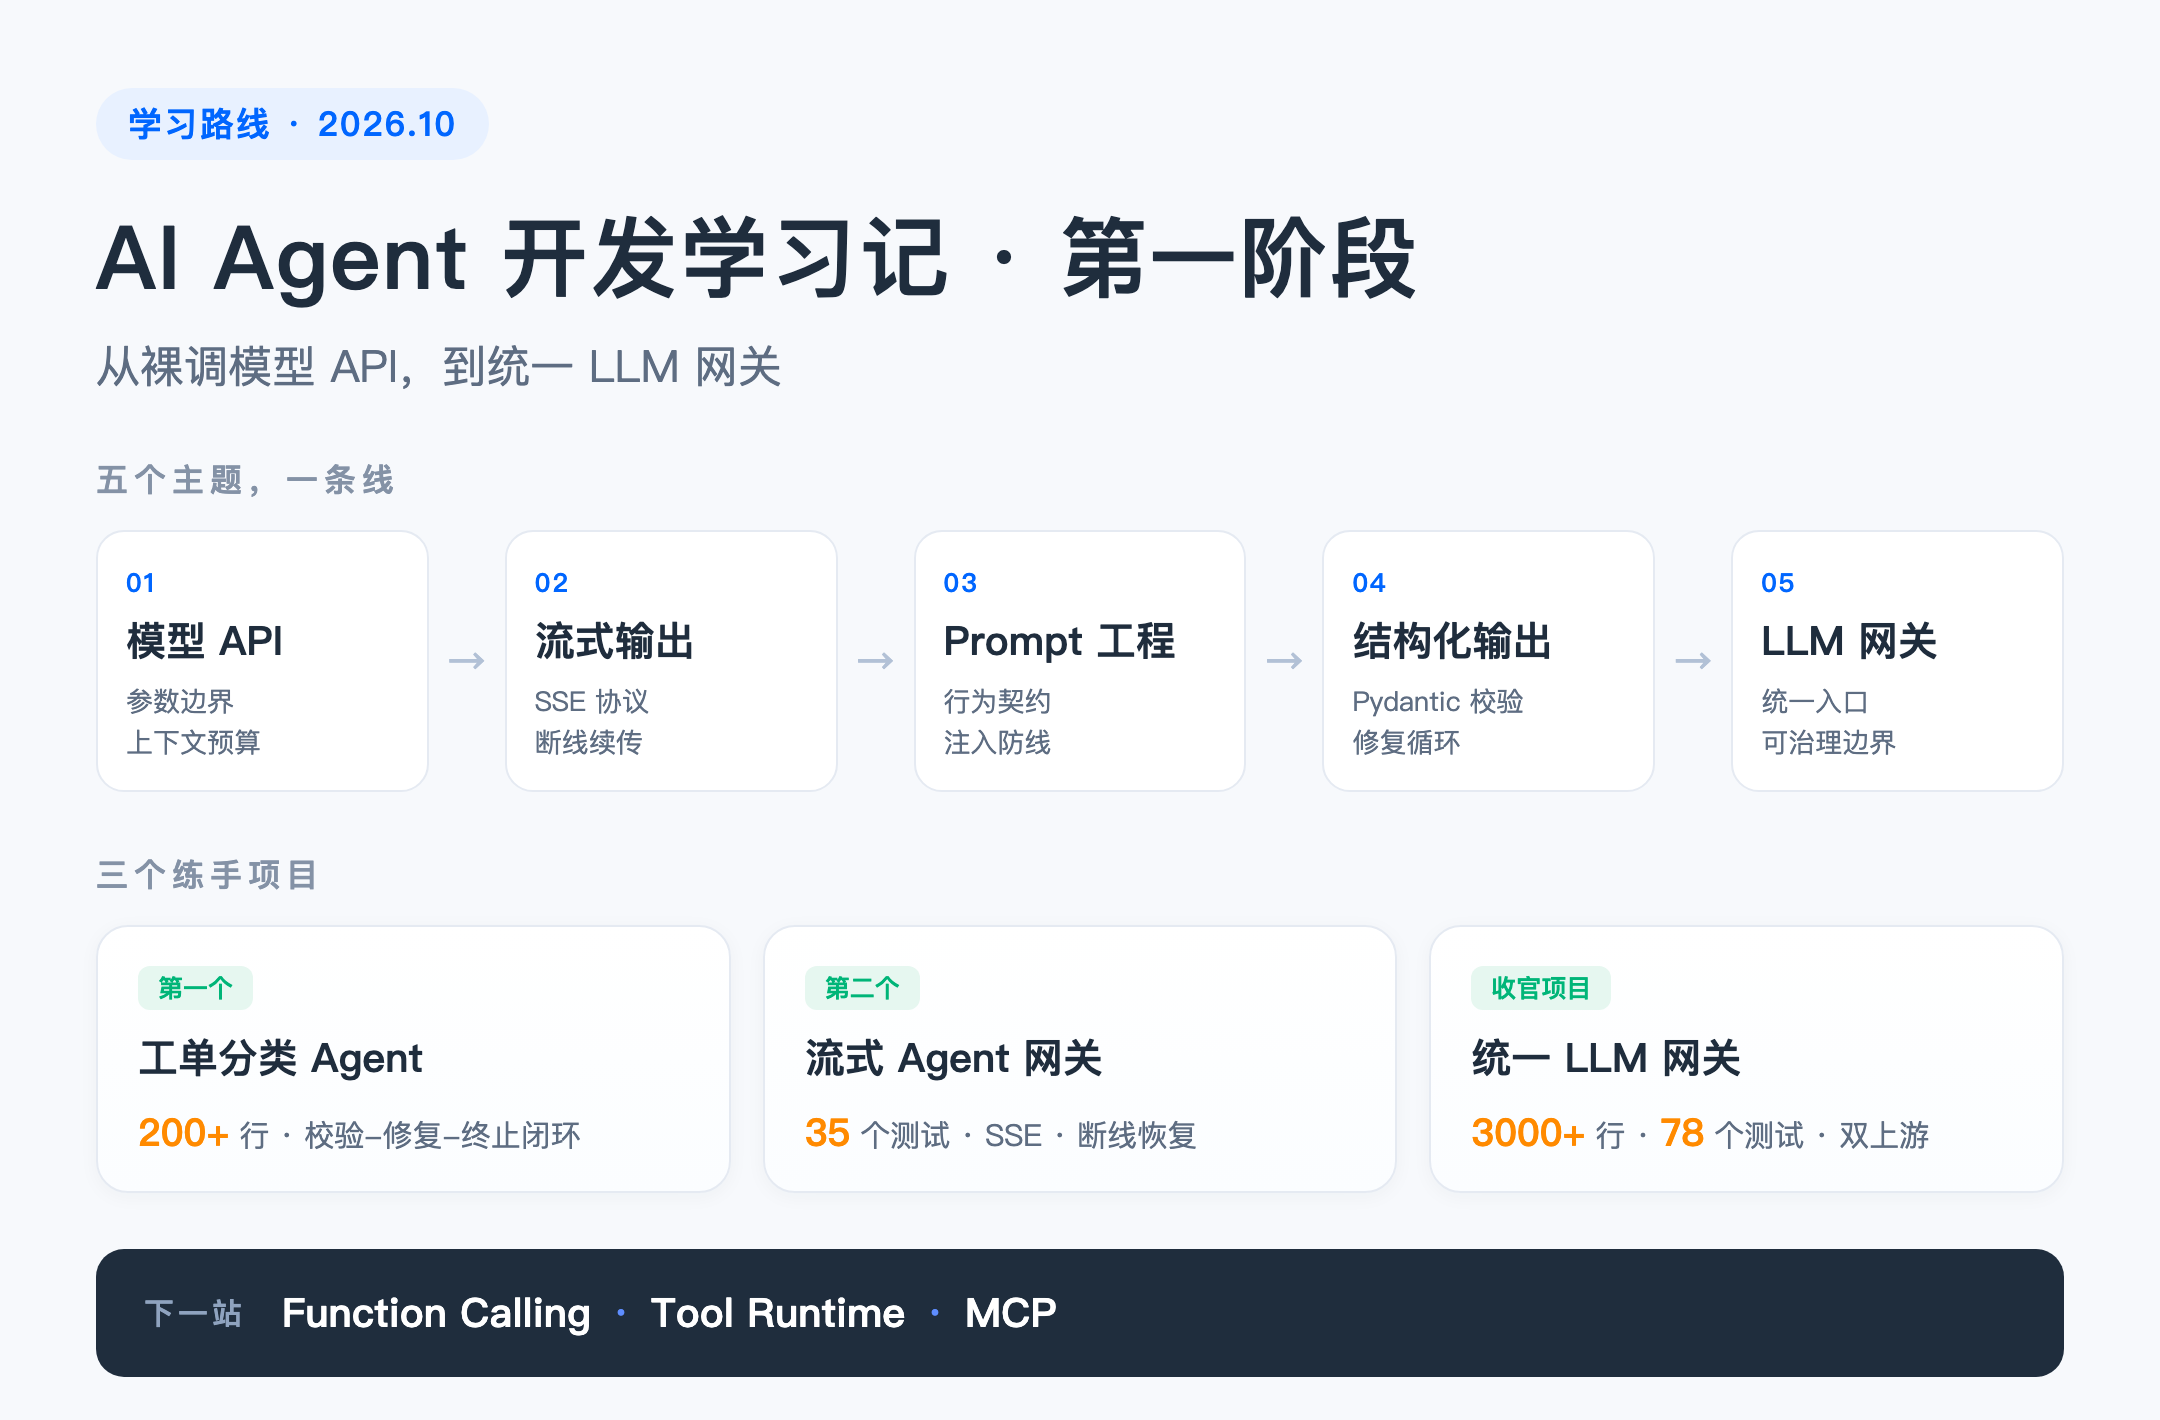
我给自己的路线是:Chat API 的请求结构、流式输出、Prompt 工程、结构化输出、LLM 网关,五块内容串成一条线。现在回头看,这条线其实回答了一个问题——怎么把一次概率性的模型调用,变成一个可控、可验证、可替换的工程组件。
flowchart TD
    A[模型 API
参数 · 上下文预算] --> B[流式输出
SSE · 断线续传]
    B --> C[Prompt 工程
行为契约]
    C --> D[结构化输出
Pydantic 校验 · 修复]
    D --> E[LLM 网关]
    E --> F[收官:统一 LLM 网关
路由 · 熔断 · 记账]
几个印象深的点。
参数不是质量旋钮。 之前我的直觉是「答得不好就调调 temperature」。系统学下来才发现,temperature 控制的是采样随机性,输出质量问题几乎都出在目标定义、上下文、输出约束上,参数排在最后。另外 max_tokens 不只是「希望模型多写点」,它是输出预算,也是停止条件——finish_reason == "length" 说明输出被截断了,被截断的 JSON 看起来像 JSON,但语义已经残缺,正确做法是当失败处理重试,而不是硬解析。
上下文是预算,不是仓库。 一次调用的容量公式很简单:system + 用户输入 + 历史消息 + 工具结果 + 预留输出 ≤ 上下文窗口。但真写起来才意识到,输入越长,留给输出的空间越小,工具返回的全文日志最容易把任务指令挤出窗外。负责裁剪上下文的是你的代码,不是模型——模型没有无限记忆。
流式输出是协议问题。 我用 FastAPI 实现了一版 SSE 网关之后才真正理解三个层次:HTTP 传输层的 chunk、SSE 帧协议的事件、业务层的事件,三者不是一一对应的。一次 read 可能只有半条 SSE,一个 delta 可能是空的。「断线续传恢复的是事件流,不是模型输出」——重连时按 Last-Event-ID 重放事件账本就行,绝不能重新调模型,因为模型是概率系统,第二次调用会生成另一条路径,前后拼接就是语义冲突。
Prompt 是行为契约。 「你是一名资深专家」这种写法无法验收。换成可观察的行为定义:「修改前必须先读取目标文件」「结论必须引用工具结果,没有证据就标记为假设」。前者验收时无从下手,后者查一下工具调用轨迹就能判断。Prompt 注入的防护思路也类似:指令和数据分区、声明信任边界、高风险动作由程序拦截,三层防线里最后一层才是硬的——模型被骗是概率事件,权限收敛是确定性事件。
结构化输出是 Agent 的地基。 自然语言没法安全地驱动程序分支。我用 Pydantic 定义契约,让模型按 Schema 输出,校验失败把具体错误反喂给模型修复(限次数),多次失败就返回 failed 终态,绝不猜一个默认值继续执行:
flowchart TD
    A[模型输出 JSON] --> B{Pydantic 校验}
    B -->|通过| C[ok · decision 进入下游]
    B -->|失败| D{修复次数 ≤ 2 ?}
    D -->|是| E[错误反喂模型
哪里错 · 为什么 · 改什么]
    E --> A
    D -->|否| F["failed · decision=None
不猜默认值"]
这套「校验-修复-终止」的循环,后面做 Function Calling 时会原样复用——模型发起的工具调用请求,本质上就是一份需要校验的结构化输出。
这条线走完,我把五个话题合成了一个项目:一个统一的 LLM 网关,后面细说。
Java 老兵第一次用 Python 做正经项目
Python 我之前只用来写脚本:处理日志、批量改文件,几十行跑完就扔。这次是第一次用 Python 做项目化开发——依赖管理、虚拟环境、pytest、模块划分,全流程走了一遍。语法上的差异,有些适应得快,有些别扭了很久。
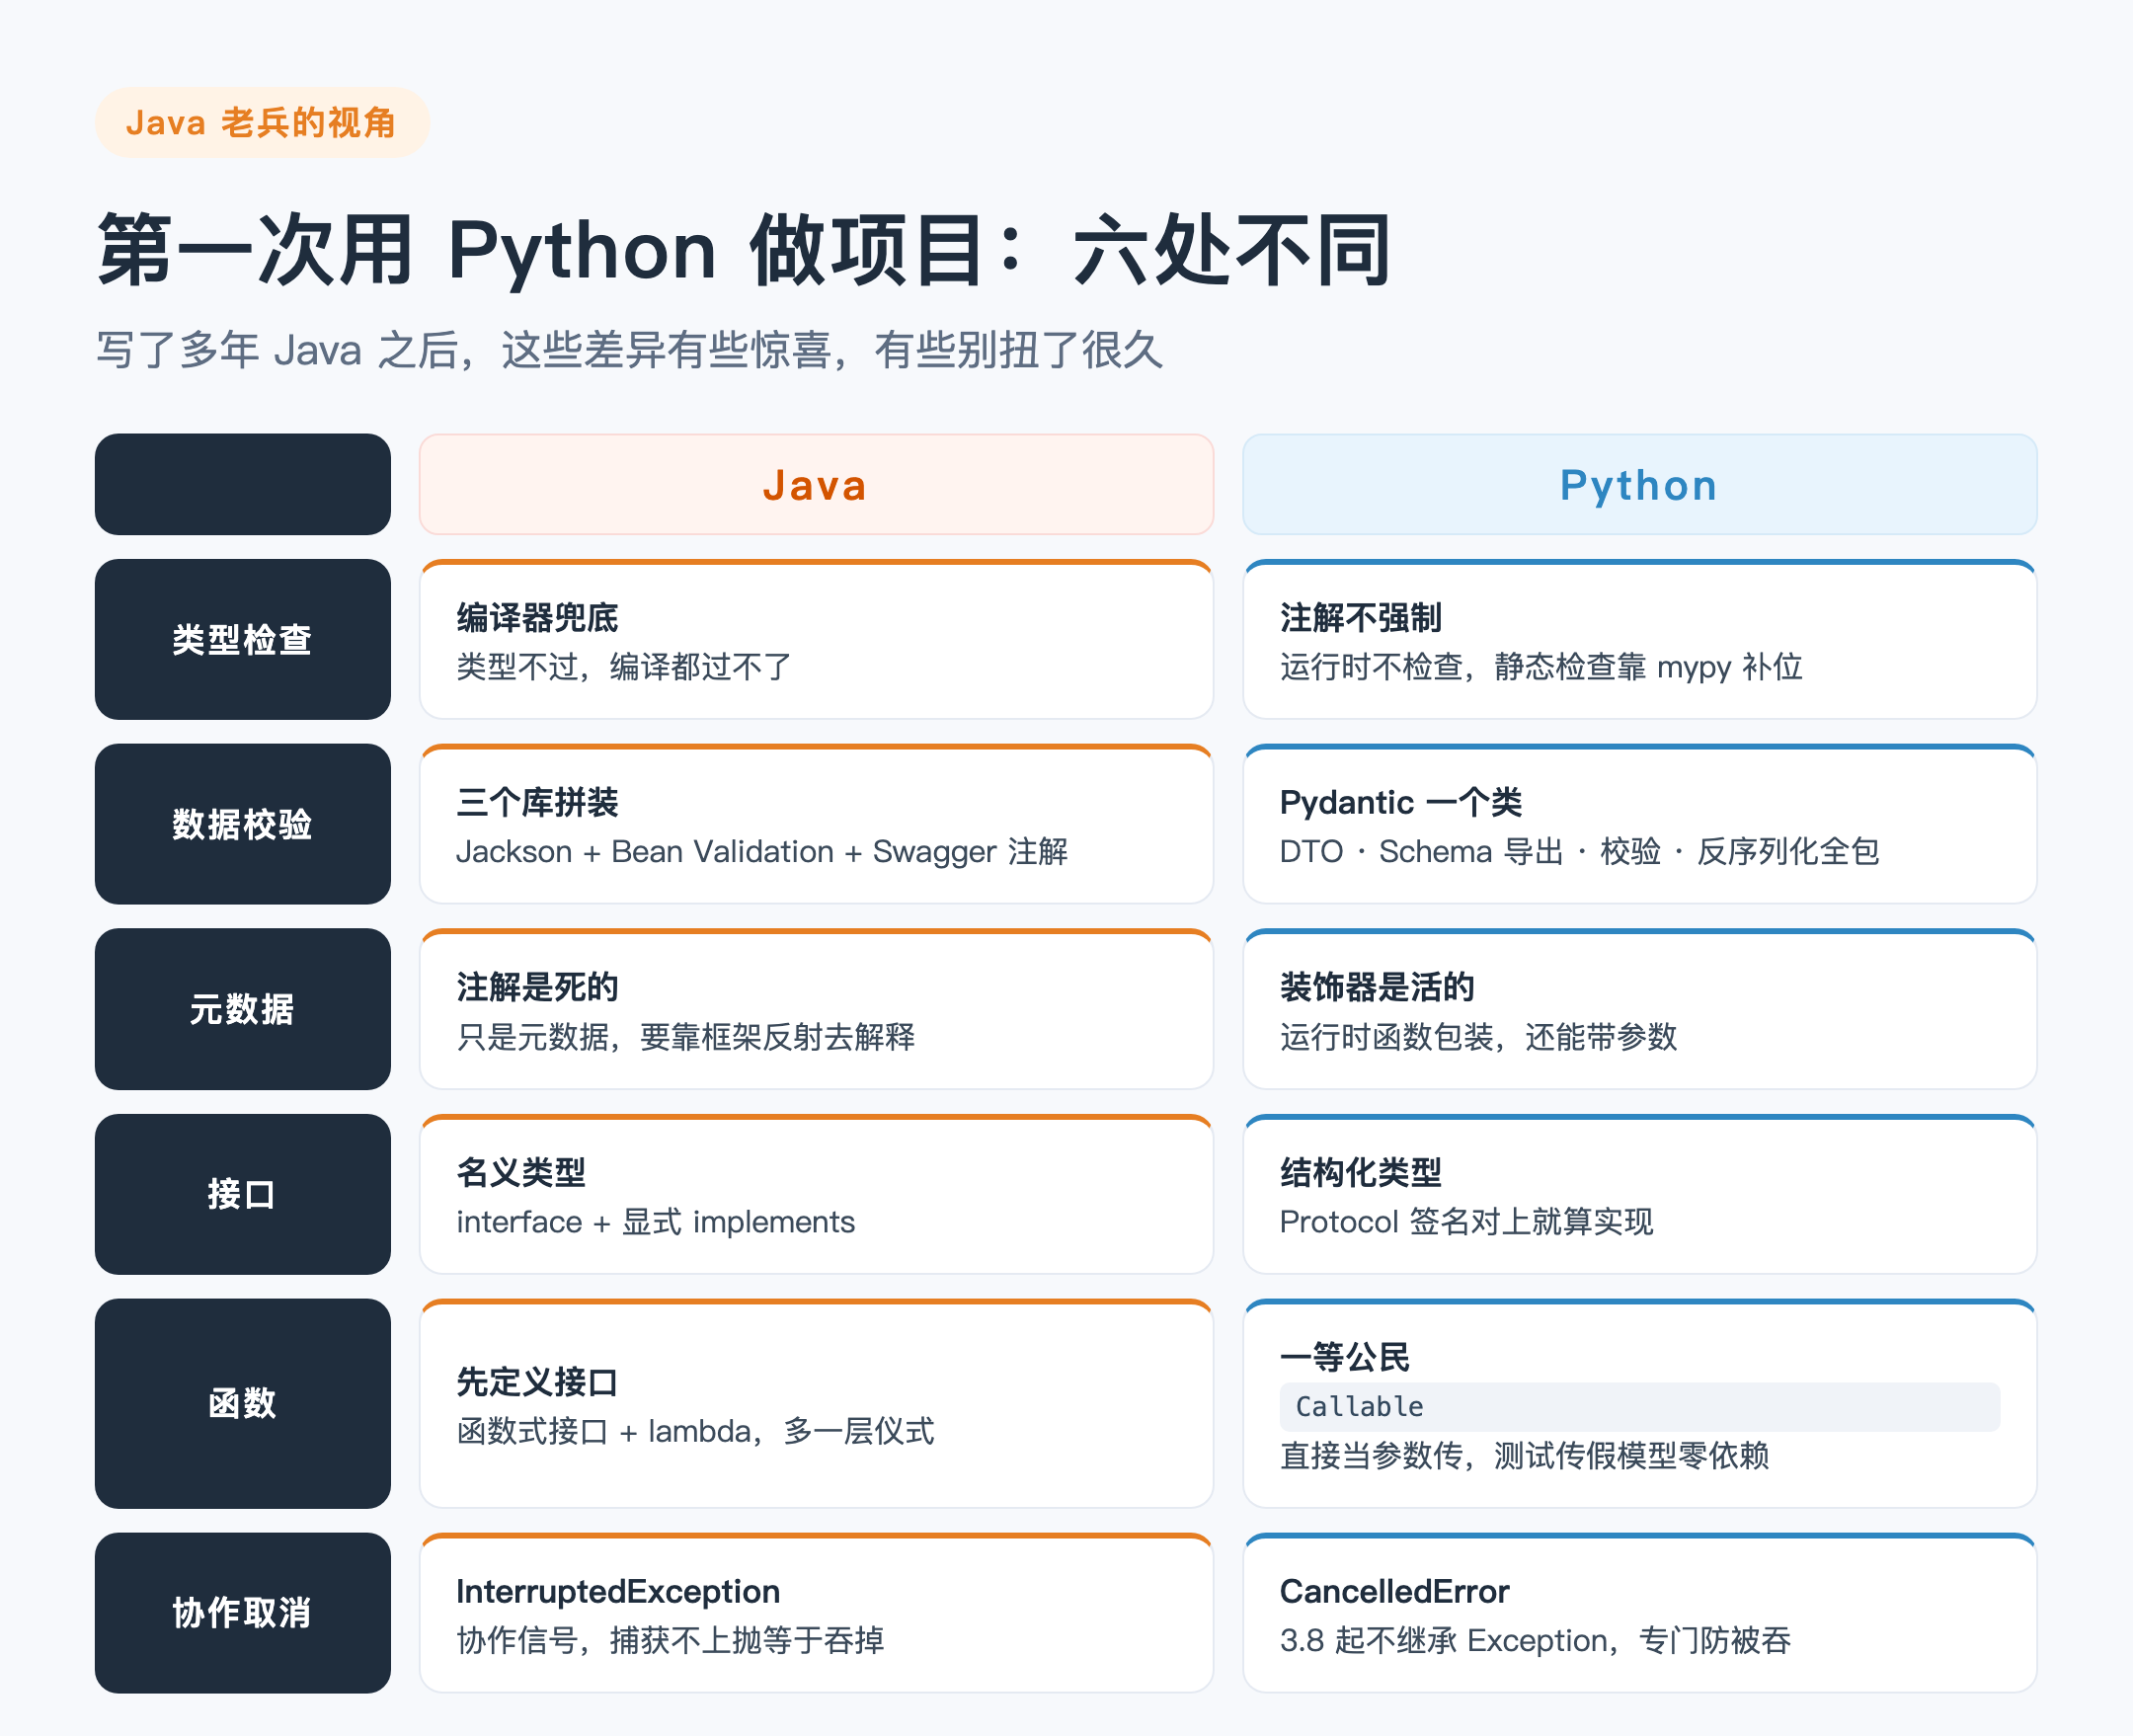
类型注解写了不等于有人检查。 Python 的类型注解运行时不强制,def f(x: str) 传个 int 进去照样跑,炸在离调用点很远的地方。静态检查要靠 mypy 这类工具补上。Java 的类型系统是编译器兜底的,这一层安全感 Python 给不了,得靠纪律和工具。倒是 str | None 这种联合类型写法我挺喜欢,Java 里最接近的只有 Optional,表达力差一截。
Pydantic 一个类顶 Java 三个库。 这是最大的惊喜。一个 Pydantic Model 同时干四件事:定义 DTO、导出 JSON Schema 给模型、校验输入、反序列化成对象。Java 里这套流程要 Jackson 加 Bean Validation 再加 Swagger 注解,三个库拼起来,注解写得满屏都是。Pydantic 的校验错误信息还自带字段路径和原因,喂回给模型修复正合适:
1 | class TicketDecision(BaseModel): |
extra="forbid" 拒绝未知字段,对应 Jackson 的 FAIL_ON_UNKNOWN_PROPERTIES;@model_validator 做跨字段校验,对应自定义 ConstraintValidator。能力对得上,只是全压缩在一个类里。
装饰器是活的,注解是死的。 Java 注解只是一份元数据,本身没有行为,要靠框架反射去解释。Python 的装饰器是运行时的函数包装,@model_validator(mode="after") 括号里能带参数,本质是「先调用这个函数、拿它返回的装饰器再去包装方法」。理解这一层之后,看 FastAPI 的 @app.post("/runs") 就顺了——它不是声明,是真的注册。
Protocol 是鸭子类型的静态版。 Python 的 Protocol 定义接口,但实现类不需要声明 implements,方法签名对上就算实现(结构化类型)。Java 是名义类型,必须显式声明。写 Adapter 的时候我用 Protocol 定义了 StreamingModel 接口,Fake 实现和真实 Adapter 都不声明继承关系,静态检查照样通过。宽松,但检查能力确实弱一档。
函数是一等公民。 模型调用在我的工单分类练习里就是一个参数:ModelCall = Callable[[list, dict], str],主流程完全不感知模型从哪来。测试时传一个脚本化的假模型进去,零 SDK 依赖,毫秒级跑完。Java 里要达到同样效果得先定义函数式接口,再写 lambda,多一层仪式感。这一点上 Python 的简洁是真的香。
asyncio 的取消是异常。 asyncio.CancelledError 从 Python 3.8 起不再继承 Exception,就是防人用 except Exception 把它吞掉。这和 Java 的 InterruptedException 一个味道:都是「别人让我停」的协作信号,捕获了不上抛等于把取消请求吞进肚子。我在实现网关取消功能时专门处理了这个,协作式检查加 task.cancel() 兜底。
三个练手项目
光看不练等于没学。这个阶段我做了三个项目,复杂度递增。
工单分类 Agent(第一个,两百来行)。输入一张工单,模型只能做两个决定:转交团队,或者追问用户。练的核心是结构化输出的完整链路:Pydantic 定义协议、校验失败反喂修复(最多两次)、预算耗尽返回 failed 终态且 decision=None,宁可失败也不猜一个团队把工单路由出去。小项目,但「非法输出永远不产生副作用」这条纪律第一次落了地。
流式 Agent 网关(第二个)。用 FastAPI 实现可观察、可取消、可恢复的流式网关:POST /runs 创建任务、GET /events SSE 订阅、POST /cancel 取消,三个接口三个职责。
flowchart LR
    A[客户端] -->|"POST /runs 创建"| G[网关 · 事件账本]
    A -->|"GET /events SSE 订阅"| G
    A -->|"POST /cancel 取消"| G
    G --> B[模型 Adapter]
    A -. "断线重连 Last-Event-ID" .-> G
做了两层事件抽象:模型事件和业务事件分离,换模型只动 Adapter;SQLite 写穿做事件账本,断线重连从断点补发,模型调用次数恒为一次。35 个测试,覆盖编解码、粘包拆包、取消传播、终态唯一、断线恢复这些边界。做完这个,「断开连接不等于取消任务」这种话才算真的懂了。
统一 LLM 网关(第三个,也是这个阶段的收官项目,三千多行)。对上暴露 OpenAI Compatible API,对下接两种协议不同的上游(OpenAI Responses 协议和 Anthropic Messages 协议):
flowchart TD
    A[调用方 · OpenAI SDK] -->|"Bearer 网关密钥"| B["北向 API
OpenAI Compatible"]
    B --> C[鉴权 · 限流
Prompt 渲染 · 脱敏]
    C --> D[别名路由 · 熔断]
    D --> E["适配器 A
OpenAI Responses 协议"]
    D --> F["适配器 B
Anthropic Messages 协议"]
    E --> G[("用量账本
Token · Cost · TTFT")]
    F --> G
网关层做别名路由、流式转发、结构化输出校验、Prompt 模板版本管理、用量记账、重试/故障转移/熔断/限流、数据脱敏,78 个测试。这是第一阶段所有内容的一次总装,架构上就是一个标准的 Spring Cloud Gateway 移植:北向统一协议、防腐层隔离上游、路由按能力匹配、密钥只在网关内。三个不变量我盯得最紧:没过 Schema 校验的输出不能进 Agent Loop;流式输出首块发出后不能换模型重写;无论主备模型,上层只依赖同一套协议。
几个扎人的认知
这个阶段最大的收获不是某个 API 怎么调,是几个观念被掰过来了。
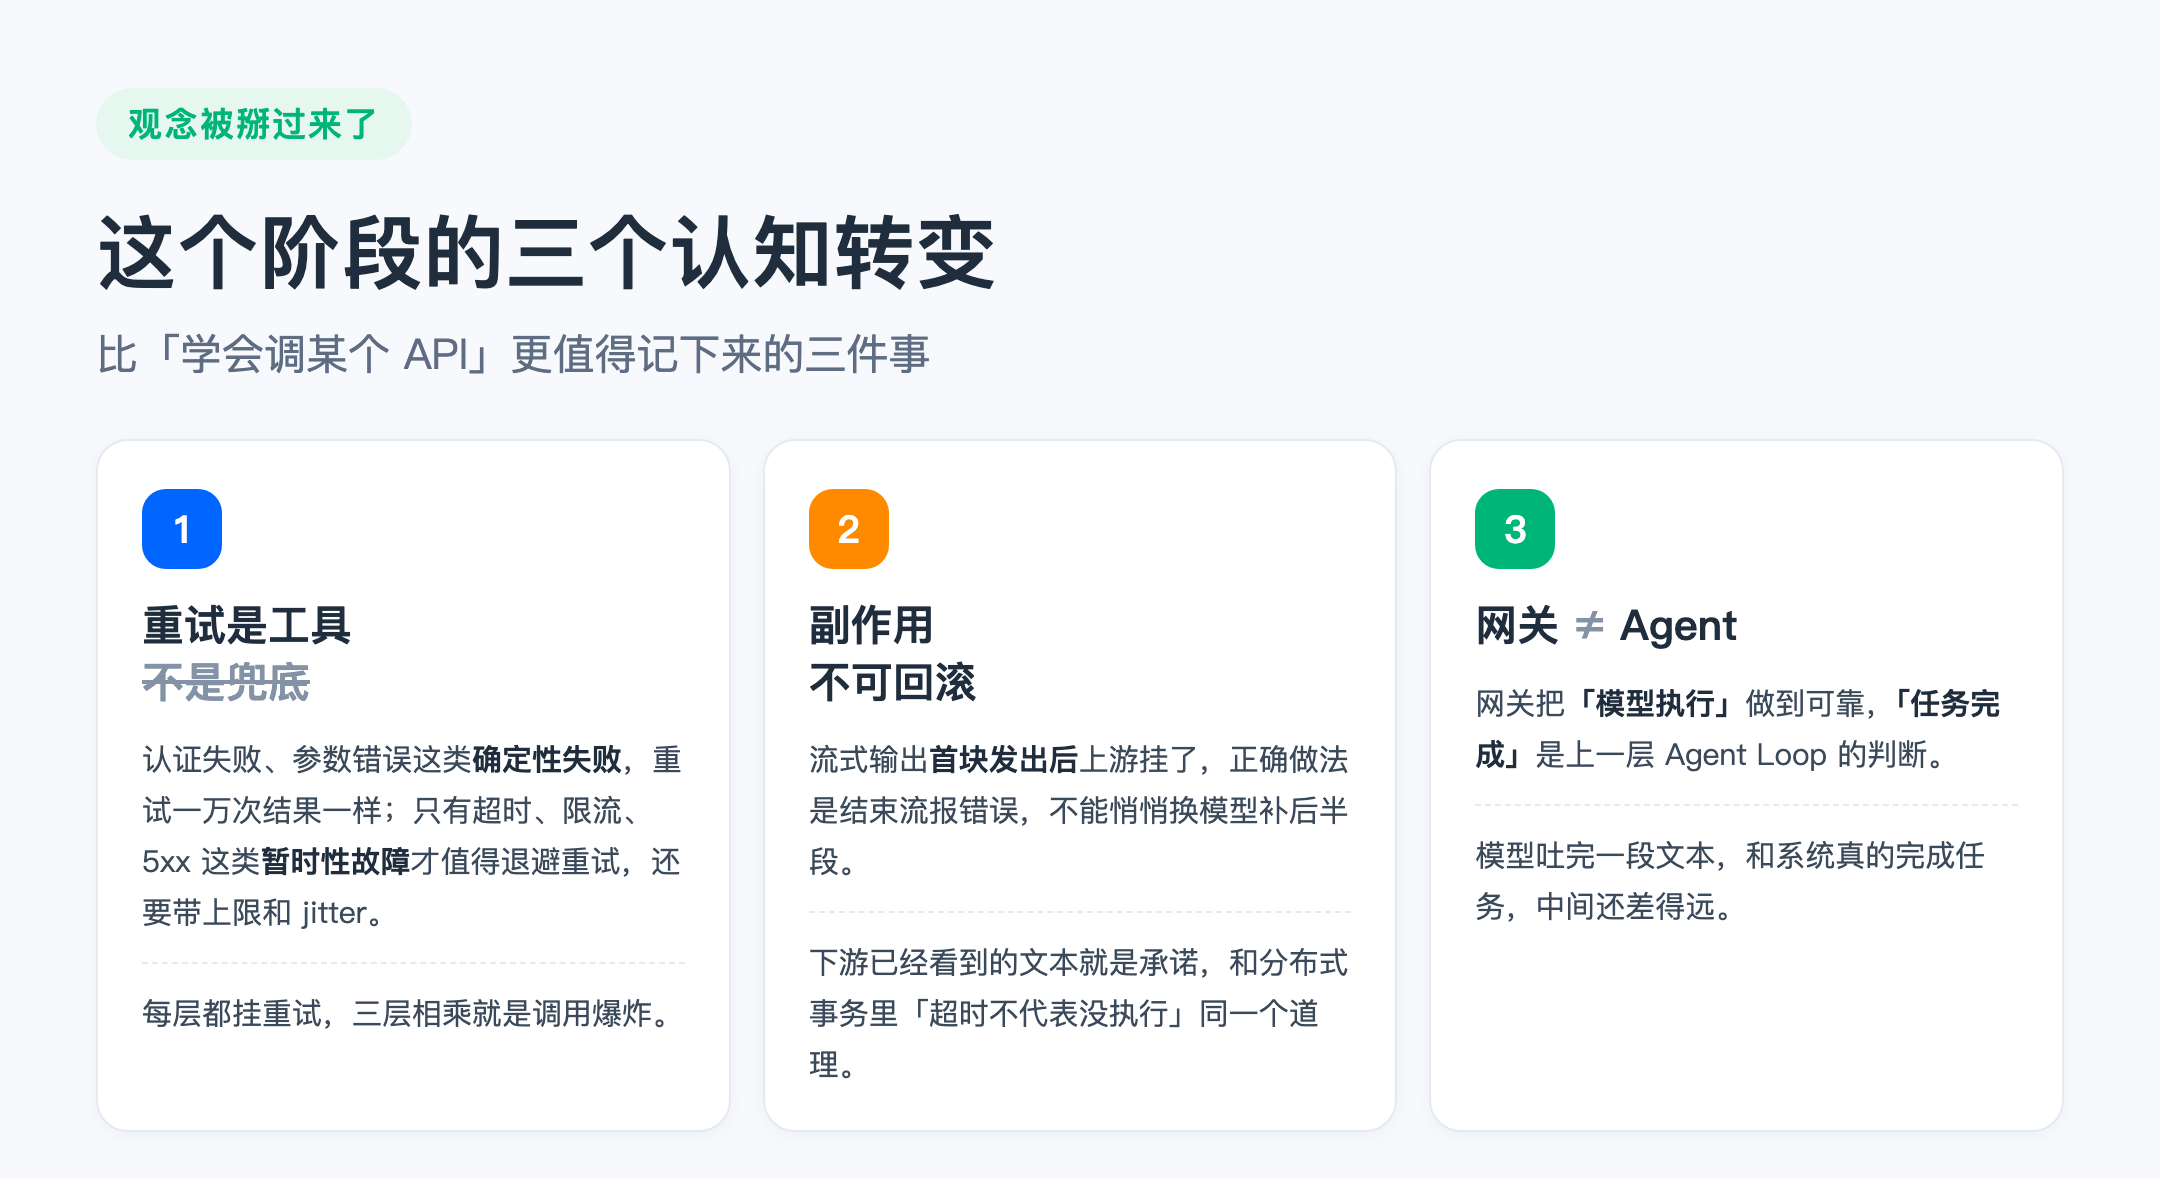
重试是工具,不是兜底。认证失败、参数错误这类确定性失败,重试一万次结果一样;只有超时、限流、5xx 这类暂时性故障才值得退避重试,而且要带上限和 jitter。每层都挂重试的话,三层重试相乘就是调用爆炸。
「已经发生的事」不能当没发生。流式输出第一块已经发给下游之后,上游挂了,正确做法是结束流报错误,而不是悄悄换个模型把后半段补上——下游已经看到的文本是不可回滚的副作用。这和分布式事务里「超时不代表没执行」是同一个道理。类似的还有:幂等键挡得住你这边重复请求,挡不住供应商那边已经计的费。
网关不等于 Agent。第一阶段的网关把「模型执行」做到了可靠,但「任务做没做完」是上一层 Agent Loop 的判断。模型吐完一段文本,和系统真的完成任务,中间还差得远。
下一阶段:Function Calling、Tool Runtime、MCP
第一阶段的网关有个明显的局限:它只会「说」,不会「做」。模型收到请求返回文本,仅此而已。要变成 Agent,得让模型能调用外部工具、拿到真实世界的结果、再决定下一步。下一阶段就学这个:
- Function Calling:模型怎么表达「我要调用某个工具、参数是什么」——协议层面它就是一份结构化输出,这也是我把结构化输出放在第一阶段啃完的原因;
- Tool Runtime:工具在哪执行、权限怎么管、副作用怎么处理、超时和取消怎么传播;
- MCP:工具生态的标准化协议,让一个工具实现能被不同的 Agent 复用。
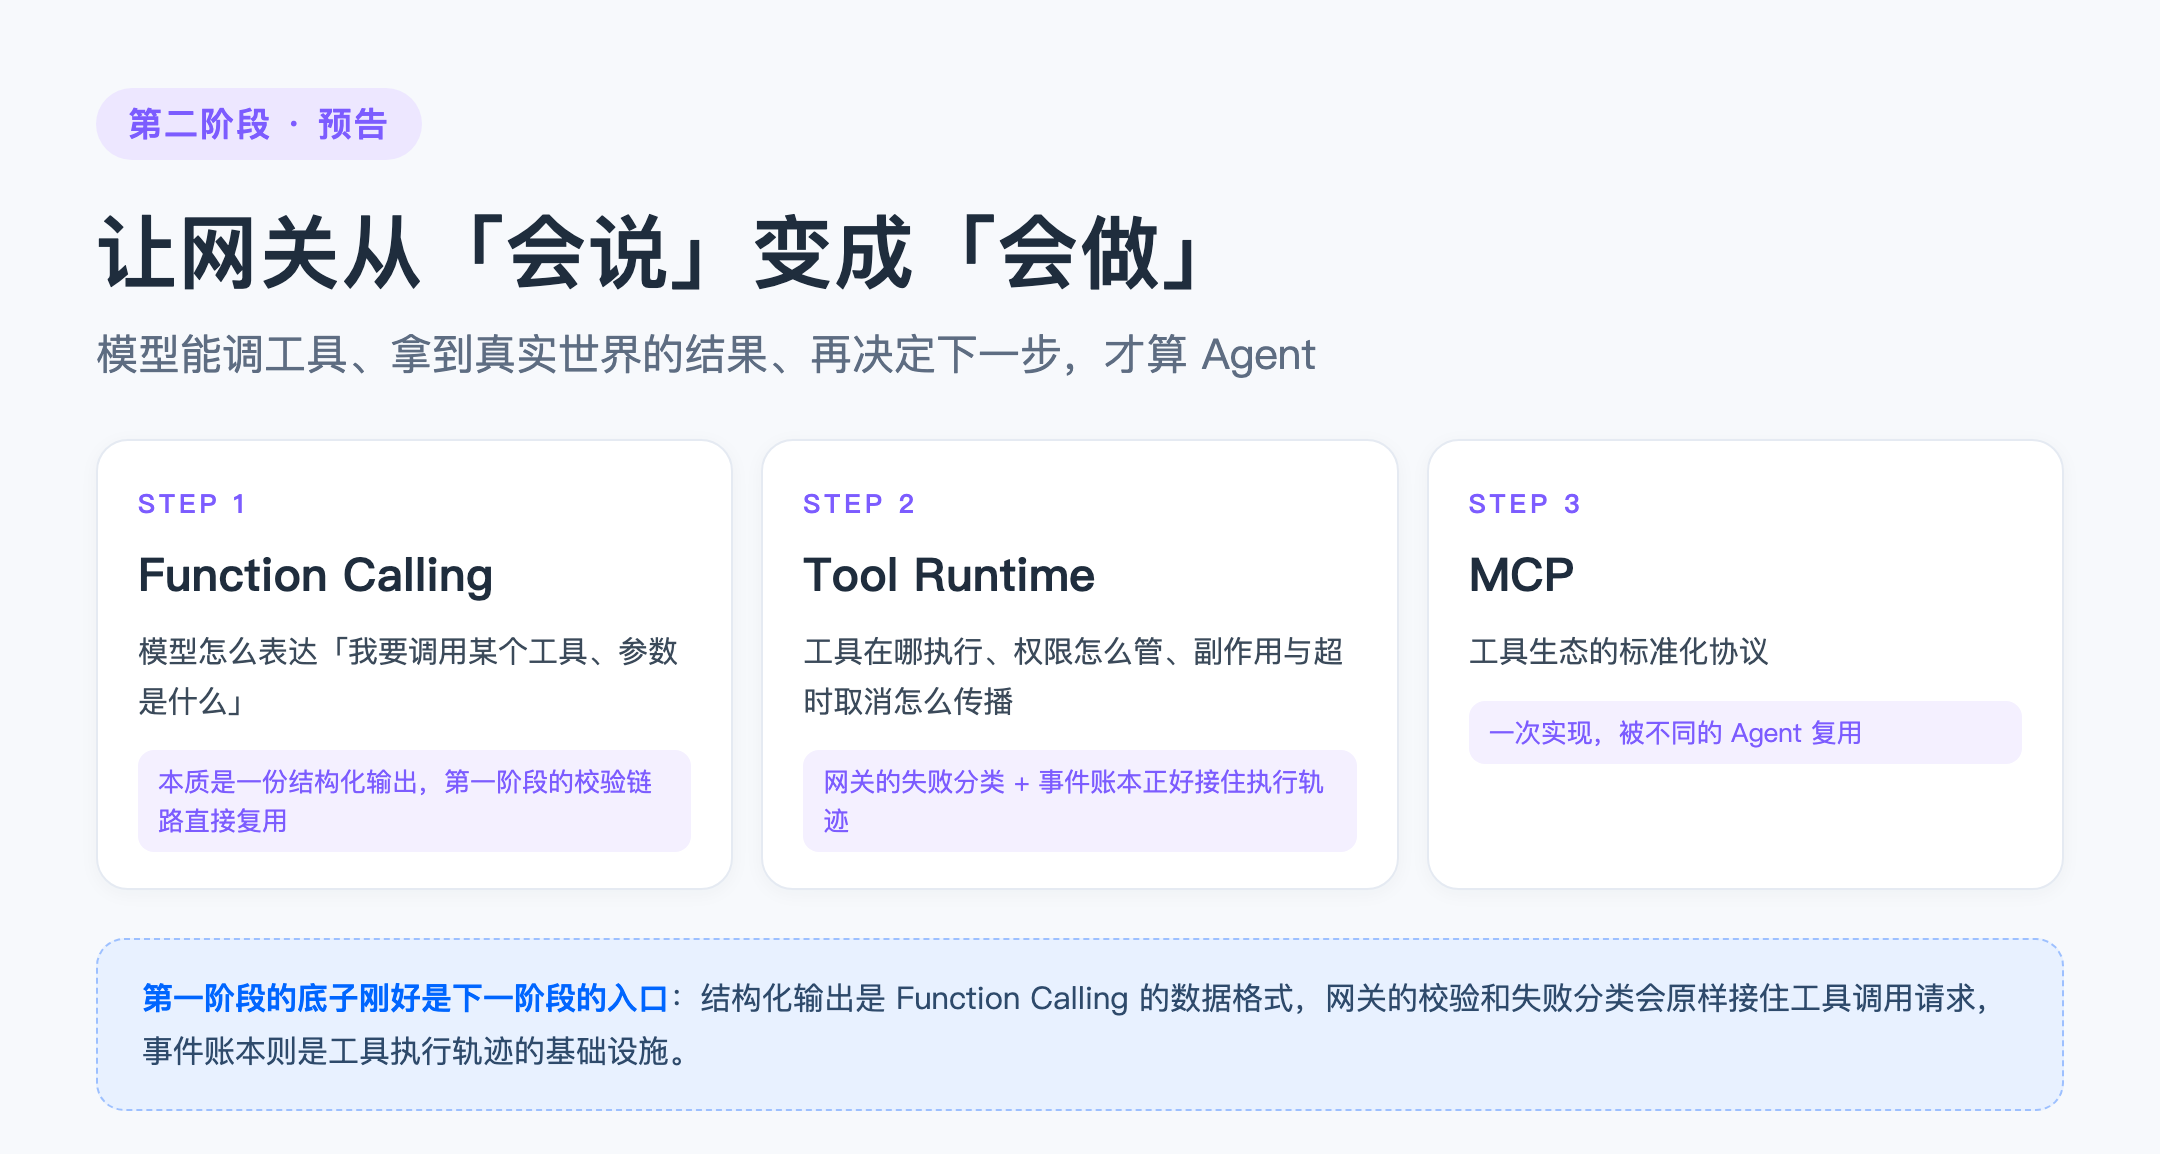
从路线图上看,第一阶段打的底子刚好是下一阶段的入口:结构化输出是 Function Calling 的数据格式,网关的校验和失败分类会原样接住工具调用的请求,事件账本则是工具执行轨迹的基础设施。
从十月底动笔到写这篇总结,第一阶段收尾,五个话题都落了代码、跑了测试。慢一点也没关系,地基这种东西,快不得。
有同样在学 Agent 开发的朋友,欢迎交流路线和踩坑经验。